03 / retrieval · KI, die ihre Quellen nennt
RAG-Entwickler: KI-Suche und Extraktion über Ihre eigenen Dokumente
KI, die aus Ihren Dokumenten antwortet statt zu raten. Jede Antwort nennt ihr Dokument, und „nicht gefunden“ ist eine echte Antwort mit einem eigenen Weg durch den Code.
- Retrieval vom Prototyp in Produktion bei Milo Logic
- Vektoren in PostgreSQL, neben den relationalen Daten
- Ein Evaluations-Set, das mit dem System entsteht, nicht danach
was ich baue
Antworten, die man in einer Sekunde prüfen kann.
Sie haben Dokumente. Leute müssen ihnen Fragen stellen und dem trauen, was zurückkommt. Das meiste davon passiert, bevor das Modell überhaupt beteiligt ist.
RAG-Suche
Suche, die die Frage versteht, über Dokumente, die nur Sie haben
Dokumenten-Extraktion
benannte Felder, herausgezogen aus Verträgen, Formularen und Berichten
Frage-Antwort-Systeme
Antworten mit ihren Quellen daneben, damit jeder eine davon prüfen kann
hybride Suche
Bedeutung und Filter in einer Query, weil echte Fragen meistens beides sind
Ingestion-Pipelines
PDFs, Scans und Exporte eingelesen und aktuell gehalten, während sie sich ändern
KI-Workflows
ein Modell, das einen abgegrenzten Schritt in einem Prozess erledigt, den Sie schon fahren
Evaluations-Sets
echte Fragen mit den Quellen, die sie beantworten sollten, bei jeder Änderung neu gefahren
KI im bestehenden Produkt
Retrieval in Software ergänzt, die Sie schon betreiben — kein zweites Produkt daneben
wie es abläuft
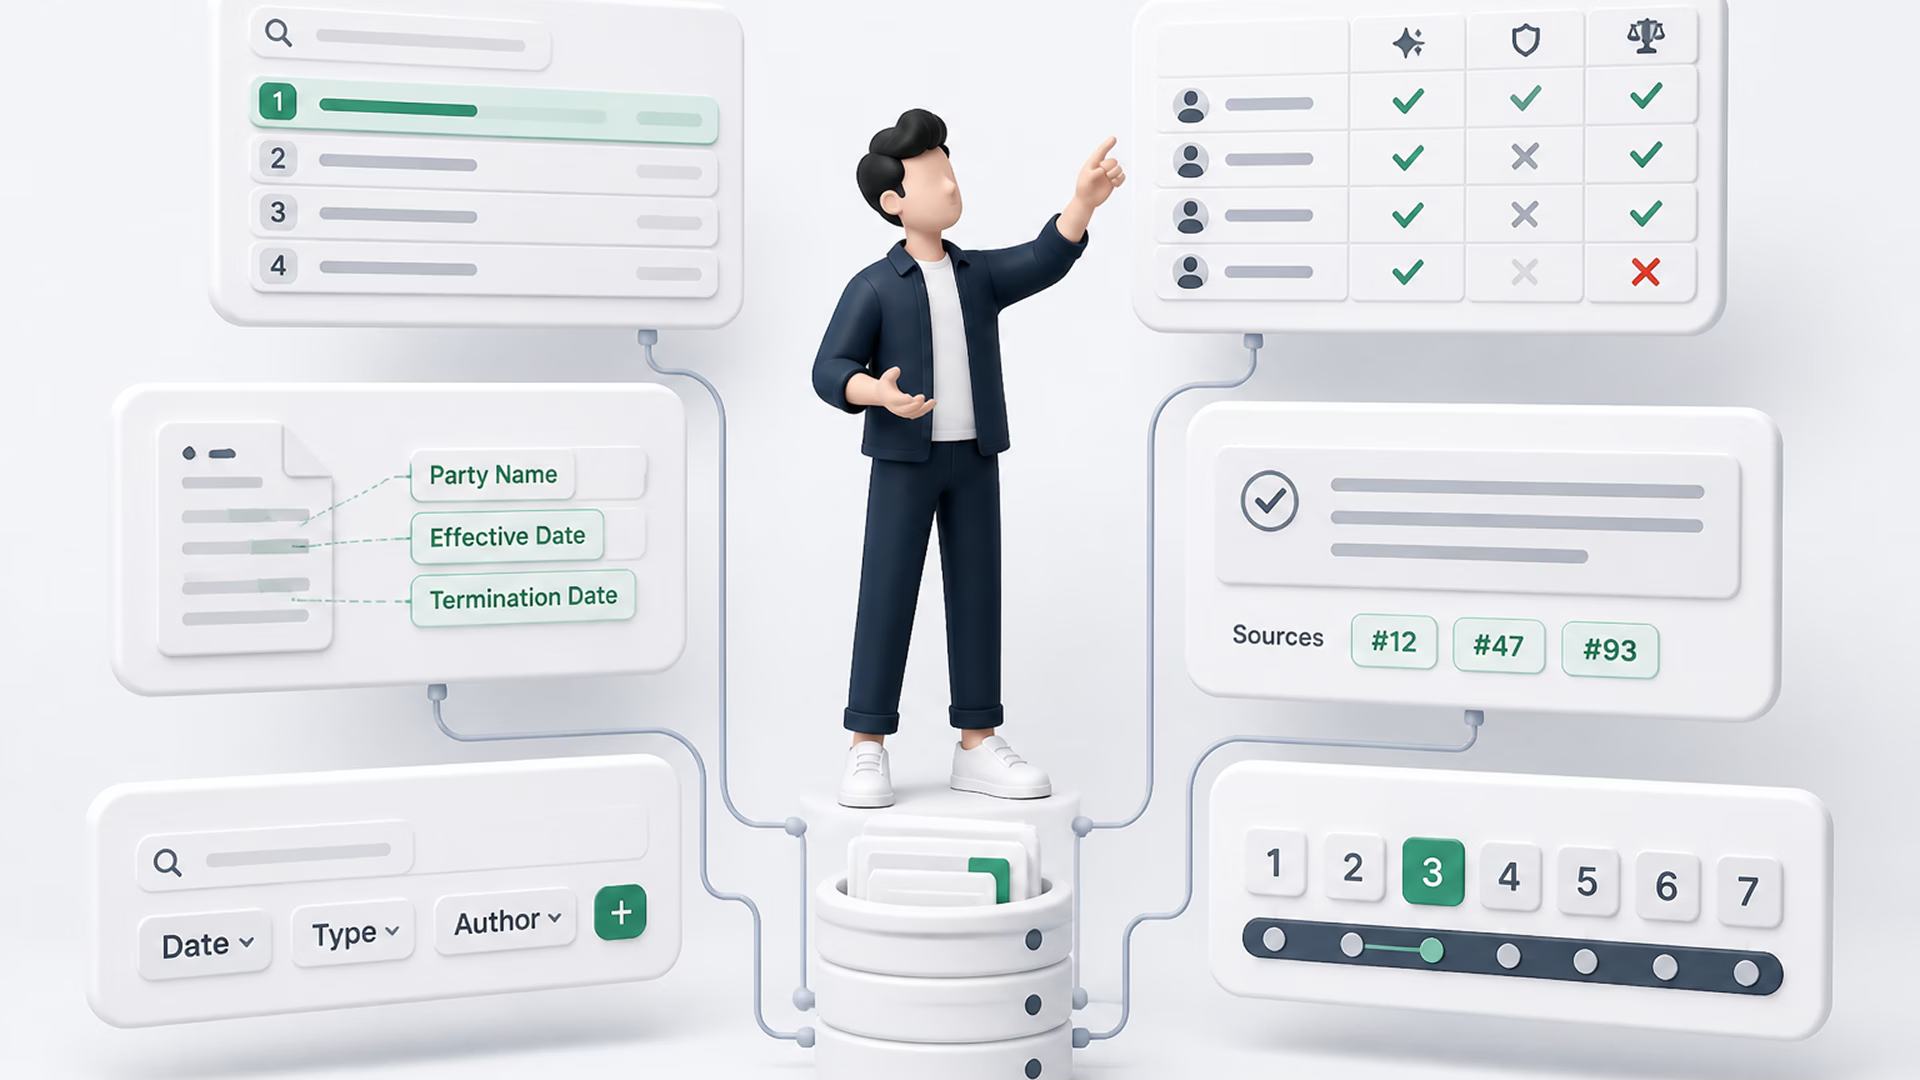
Korpus, Retrieval, Antwort, Beleg.
Den Satz zu erzeugen ist der letzte Schritt und der kleinste. Alles davor entscheidet, ob der Satz stimmt.
lesen
Ihre Dokumente hinein — PDFs, Scans, Exporte, und was die letzten zehn Jahre sonst hinterlassen haben
schneiden
jedes Dokument in Stücke geteilt, die auch für sich allein noch Sinn ergeben
finden
Vektorsuche über diese Stücke, in derselben Query wie Ihre gewöhnlichen Filter
antworten
die Antwort, die Quellen daneben auf dem Screen, und ein echter Weg für „das habe ich nicht gefunden“
warum retrieval
Ein allgemeines Modell rät. Retrieval lässt es erst nachsehen.
Fine-Tuning bringt einem Modell einen Stil bei. Retrieval reicht ihm den Absatz. Nur eines von beidem kann Ihnen zeigen, woher die Antwort kam.
- Ihre Dokumente, nicht das Internet
- das Modell antwortet aus Ihren Verträgen und Ihren Tickets, nicht aus dem, was es im Training gelesen hat.
- Recall vor Precision
- eine falsche Passage wird ignoriert. Eine fehlende wird trotzdem beantwortet, flüssig, und klingt genauso wie eine richtige.
- Bedeutung und Filter zusammen
- „Verlängerungen, die nach März vereinbart wurden“ ist halb Suche und halb Datumsspalte. Beides läuft in Postgres, in einer Query.
- Quellen auf dem Screen
- eine Antwort, die man nicht prüfen kann, ist ein Gerücht. Die erste falsche, die niemand bemerkt, beendet das Projekt.
- „unsicher“ ist eine Antwort
- ein Endpoint, der immer etwas liefern muss, wird immer etwas liefern.
- gemessen, nicht diskutiert
- jede Änderung an Chunking, Embedding-Modell oder Prompt wird gegen Ihre eigenen Fragen bewertet.
die probleme, die ich löse
Einen dieser Sätze haben Sie wahrscheinlich schon laut gesagt.
“Wir haben einen Chatbot auf unsere Dokumente gesetzt. Er klang überzeugt, lag zweimal falsch, und jetzt benutzt ihn niemand mehr.”
Er hat geantwortet, ohne die richtige Passage vor sich zu haben. Ich repariere zuerst das Retrieval und stelle dann die Quelle auf den Screen, damit die nächste falsche Antwort in einer Sekunde auffällt statt in einem Quartal.
“Eine Person im Team findet den richtigen Absatz, und alle anderen warten auf sie.”
Das ist ein Suchproblem, bei dem ein Mensch den Index ersetzt. Die Antworten stehen längst in den Dokumenten; es fehlt nur das Mittel, sie zu fragen.
“Die Antworten liegen irgendwo in zehn Jahren Verträgen und Tickets.”
Ingestion, Chunking und Vektorsuche über den Korpus, den Sie bereits haben, mit den Filtern, nach denen Ihr Team ohnehin sucht.
“Wir brauchen Felder aus diesen Dokumenten, kein Chat-Fenster.”
Dieselbe Pipeline, anderes Ende. Sie bekommen benannte Felder, damit Ihre übrige Software einen Vertrag als Daten behandeln kann.
“Woran würden wir überhaupt merken, dass es besser geworden ist?”
An einem Evaluations-Set, das neben dem System entsteht — echte Fragen, die Quellen, die sie beantworten sollten, bei jeder Änderung neu gefahren. Die Alternative ist, im Meeting darüber zu streiten.
- PostgreSQL
- pgvector
- Embeddings
- Vector search
- Document extraction
- evals
Die Vektoren liegen in PostgreSQL neben Ihren übrigen Daten, sodass eine Frage mit Filter eine Query bleibt statt eines von Hand geschriebenen Joins im Anwendungscode. Den Screen darüber baue ich mit.
how I build it
The vectors live in PostgreSQL, beside the rest of your data, through an extension called pgvector.
Most real questions are half meaning and half filter. "What did we agree with this client about renewals, in contracts signed after March." The first half needs vector search. The client and the date are ordinary columns. Split those across two systems and you write that join by hand, in application code, every time somebody asks.
Retrieval aims for recall before precision. A wrong passage in front of the model usually gets ignored. A missing one is worse: the model does not tell you it came up empty. It answers anyway, fluently, and it sounds the same as when it is right. So the search step brings back more than it needs on purpose, and a ranking step narrows it down.
Every answer shows the documents it came from, on screen, next to the words. That one detail decides whether anyone is still using the system in month three. An answer you cannot check is a rumour. The first time somebody catches one being wrong, they stop trusting all of them.
"I could not find that" is a real answer with its own path through the code. An endpoint that must always produce something will always produce something.
when a project needs more than me
Retrieval, extraction and answering cover most of what teams actually need, and they share a useful property: every output can be checked against a source.
Some projects reach past that, into model fine-tuning, custom training or heavier machine learning. For those I bring in senior AI engineers I already work with. The pipeline, the data model and the interface stay with me, and the specialist work happens inside the same project.
wie die zusammenarbeit aussieht
Sie bringen es. Ich übernehme. Sie bekommen es besser zurück.
you bring
- die Dokumente, und die Fragen, die Ihr Team nicht beantwortet bekommt
- wer auch immer weiß, welche Antwort die richtige ist
- die Filter, nach denen Sie ohnehin suchen — Kunde, Datum, Status
I handle
- Ingestion, Chunking und Embedding
- Vektorsuche in PostgreSQL, neben Ihren relationalen Daten
- Ranking, und der Weg für den Fall, dass nichts gefunden wird
- die Oberfläche, die Quellen neben Antworten stellt
- das Evaluations-Set, und die Bewertung bei jeder Änderung
- Deployment, innerhalb Ihrer eigenen Infrastruktur
you get
- Ihr Code und Ihre Dokumente, in Ihrer Infrastruktur
- Antworten mit der Quelle daneben, in einer Sekunde prüfbar
- eine echte Zahl für die Retrieval-Qualität auf Ihrem Korpus statt eines Versprechens darüber
Dokumente, denen niemand Fragen stellen kann?
Dreißig Minuten über den Korpus und die Fragen, an denen Ihr Team scheitert. Bringen Sie die schweren mit. Ich sage Ihnen, was Retrieval darin finden würde und ob es sich zu bauen lohnt.